Почему средний чек врёт
На выборке из 209 тысяч заказов средний чек оказался больше, чем 80% реальных покупок. Разбираем, что за распределение за этим стоит и что считать вместо среднего.
Средний чек — первая метрика в любом отчёте. И почти всегда она описывает покупателя, которого не существует.
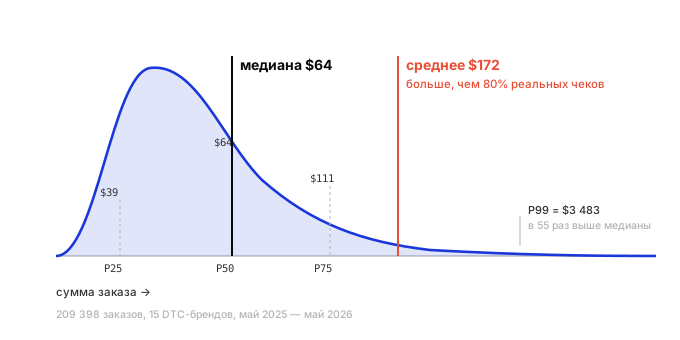
Вот данные, которые это показывают прямо. Выборка из 209 398 заказов 152 488 покупателей у 15 DTC-брендов за год с мая 2025 по май 2026:
| Показатель | Значение |
|---|---|
| Среднее арифметическое | $172.27 |
| Медиана (P50) | $63.70 |
| P25 | $38.81 |
| P75 | $111.49 |
| P90 | $248.00 |
| P99 | $3 482.86 |
Посмотрите, где находится среднее. $172.27 — это между P75 ($111) и P90 ($248). То есть «средний чек» больше, чем примерно 80% всех реальных заказов. Метрика, названная средней, описывает верхнюю пятую часть выборки.
Какое это распределение на самом деле
Не логнормальное и не Парето по отдельности, а композиция: логнормальное тело плюс степенной хвост. Это измеряли независимо на разных данных.
Мизуно с соавторами в 2008 году разобрали POS-данные японской сети магазинов у дома: плотность распределения расходов на одну покупку следует степенному закону с показателем −2, а за трёхмесячное окно — с показателем −3. Гош и соавторы на потребительских расходах в Индии за 1983–2007 годы показали, что лучшая модель — смесь логнормального и Парето, причём в степенной хвост попадает 10–20% домохозяйств. Мартин с коллегами на выборке около 60 000 домохозяйств США получили пуассон-логнормальную модель размеров корзины.
Для прогноза пожизненной ценности в Google предложили zero-inflated lognormal: точечная масса в нуле для одноразовых покупателей плюс логнормаль с тяжёлым хвостом. Это де-факто промышленный стандарт.
Где именно ломается модель
Мы проверили это численно на приведённых данных — двумя способами.
Подгонка по медиане и среднему даёт μ = 4.15, σ = 1.41 и промах во все стороны: P25 занижен в 1.6 раза, P75 и P90 завышены в полтора, P99 занижен вдвое. Причина кольцевая — среднее само испорчено хвостом, и подгонка наследует искажение.
Подгонка только по телу (P25 и медиана) ведёт себя иначе:
| Персентиль | Факт | Модель | Отношение |
|---|---|---|---|
| P25 | $38.81 | $38.81 | 1.00 |
| P50 | $63.70 | $63.70 | 1.00 |
| P75 | $111.49 | $104.55 | 0.94 |
| P90 | $248.00 | $163.31 | 0.66 |
| P99 | $3 482.86 | $351.85 | 0.10 |
Между P25 и P75 логнормаль описывает данные практически идеально — ошибка 6%. А выше P90 начинается другой режим: на P99 модель промахивается в десять раз.
Самое важное следствие. Логнормаль, подогнанная по телу, даёт математическое ожидание $83.43. Фактическое среднее — $172.27. Значит 51.6% среднего чека создаётся хвостом, которого модель не видит вообще. Половина метрики живёт за пределами того, что вы моделируете.
Один закон на разных рынках
Мы оценили показатель степенного закона в хвосте этих данных: −1.87 по паре (P90, P99) и −1.94 по паре (P75, P99). Оценка по двум точкам груба, это порядок величины, а не точное измерение.
Но сравните: Мизуно с соавторами на японских POS-данных получили −2.0. Гош с соавторами на индийских потребительских расходах — показатель в диапазоне 1.40–2.84. Американские DTC-бренды 2026 года, японские магазины у дома 2008-го и индийские домохозяйства 1983–2007 дают одну и ту же форму хвоста. Разные рынки, разные эпохи, разные способы сбора данных.
Почему крупные игроки публикуют только среднее
Shopify в официальном пресс-релизе по итогам распродаж 2025 года сообщил: $14.6 млрд оборота, более 81 млн покупателей, средняя корзина $114.70. Медианы нет. Её не публикует ни один крупный игрок — ни Dynamic Yield с мировым AOV $182, ни IRP Commerce с £133.12 по британскому рынку.
Это не злой умысел, а свойство агрегатов: среднее складывается из любых источников, медиана требует доступа к исходным транзакциям. Но следствие практическое — все публичные бенчмарки, на которые принято ориентироваться, систематически завышены относительно типичного заказа.
Что ломается в планировании. Если считать экономику закупа по среднему чеку $172, а типичный покупатель приносит $64, разрыв получается в 2.7 раза. Кампания, которая на бумаге окупалась, в реальности убыточна — и выясняется это через недели, когда бюджет уже потрачен.
Что смотреть вместо
- Медиана — типичный заказ. Устойчива к выбросам.
- P25 и P75 — между ними половина заказов. Их расстояние говорит о разбросе честнее стандартного отклонения.
- P90 и P99 — зона, где живёт хвост. В нашем примере P99 выше медианы в 55 раз: это не выбросы-ошибки, это реальные покупатели, и их вклад в выручку непропорционален их числу.
- Доля выручки по группам — сколько приносят нижняя половина, следующие 40%, верхние 10% и верхний процент.
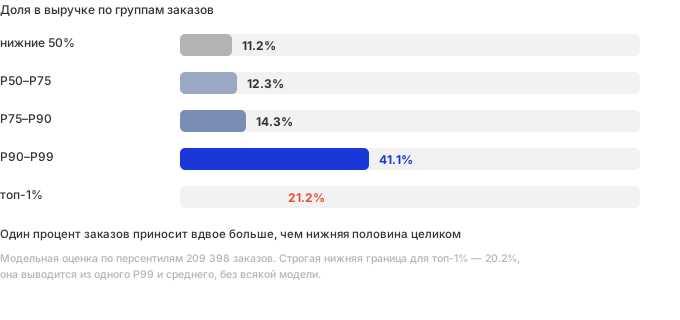
Часть этих чисел можно утверждать строго, без всякой модели. Из одного только значения P99 = $3 482.86 и среднего $172.27 математически следует, что верхний процент заказов даёт не менее 20.2% выручки, а нижняя половина — не более 14.9%. Это не оценка, это граница, которую нельзя оспорить.
Побочный результат расчёта: чтобы модель сошлась со средним, максимальный заказ в выборке должен быть около $10 200. Для 209 тысяч заказов правдоподобно — но это значит, что один заказ из двухсот тысяч стоит столько же, сколько 160 медианных.
Правило 80/20: миф в точной формулировке
Концентрация реальна, но знаменитая пропорция на данных не подтверждается.
По нашему расчёту топ-20% заказов дают 72.9% выручки, а не 80%. Линия 80% проходит примерно по топ-30% — фактическое правило ближе к «80/30».
По покупателям картина похожая. На выборке 12 DTC-брендов топ-20% покупателей приносят 56% выручки, топ-10% — 40.5%, топ-1% — 10.6%. В рецензируемом исследовании Мартина с соавторами крупнейшие 20% корзин дали 40% выручки. Ни одна цифра не дотягивает до 80.
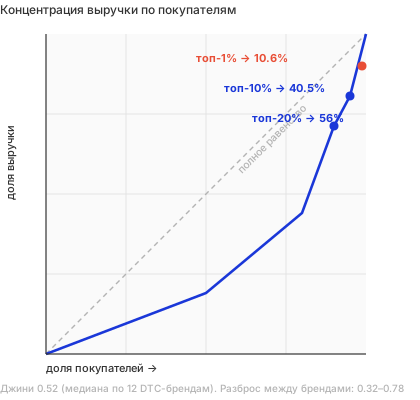
А вот что действительно важно: разброс между брендами больше, чем расстояние до «правила». Доля топ-10% покупателей гуляет от 27% до 74% в зависимости от бренда, коэффициент Джини — от 0.32 до 0.78. Это буквально разные бизнес-модели. Применять 80/20 как универсальную константу нельзя — концентрацию нужно мерить на своих данных.
Отдельно о цифре, которая кочует по отраслевым публикациям: «20% покупателей дают 70% выручки». Мы проверили её по первоисточнику — данных за ней нет. Это присказка, а не измерение.
Когда видно распределение, становится очевидно: это не одна аудитория с разбросом, а несколько разных, и привлекать их нужно по-разному. Сегмент, формирующий верхние персентили, обычно отличим по поведению задолго до покупки — но увидеть это можно, только перестав усреднять.
Источники
- Mizuno, Toriyama, Terano, Takayasu (2008). Pareto law of the expenditure of a person in convenience stores. Physica A 387(15):3931–3935. препринт
- Ghosh, Gangopadhyay, Basu (2010). Consumer expenditure distribution in India, 1983–2007. arXiv:0912.5420
- Martin et al. (2020). Johnson's SU and Poisson-lognormal models of basket size. Journal of Retailing and Consumer Services. описание
- Wang, Liu, Miao (Google, 2019). A Deep Probabilistic Model for Customer Lifetime Value. arXiv:1912.07753
- B&Co — AOV Benchmarks: датасет 209 398 заказов с персентилями (агентские данные, не рецензированные)
- Shopify BFCM 2025, пресс-релиз в SEC, 2 декабря 2025
- Dynamic Yield — AOV Benchmarks, 12 месяцев к сентябрю 2026 (вендорские данные, выборка не раскрыта)
- B&Co — Customer Concentration Benchmarks: Джини и доли топ-покупателей по 12 DTC-брендам (агентские данные)
- IRP Commerce, сентябрь 2026: AOV рынка Великобритании £133.12
- Расчёты показателя степенного закона, вклада персентилей в выручку и границ концентрации выполнены нами на опубликованных персентилях; в источниках этих величин нет